Un appel de casting arrive en français. Le profil du talent est rédigé en anglais. L'interface de l'agent est en français ce matin, en anglais cet après-midi. Dans un pays bilingue, ce croisement est le quotidien d'un logiciel de casting, et il pose une question de logique pure : comment faire se rencontrer deux vocabulaires sans jamais traduire ?
Un seul mot, trop d'orthographes
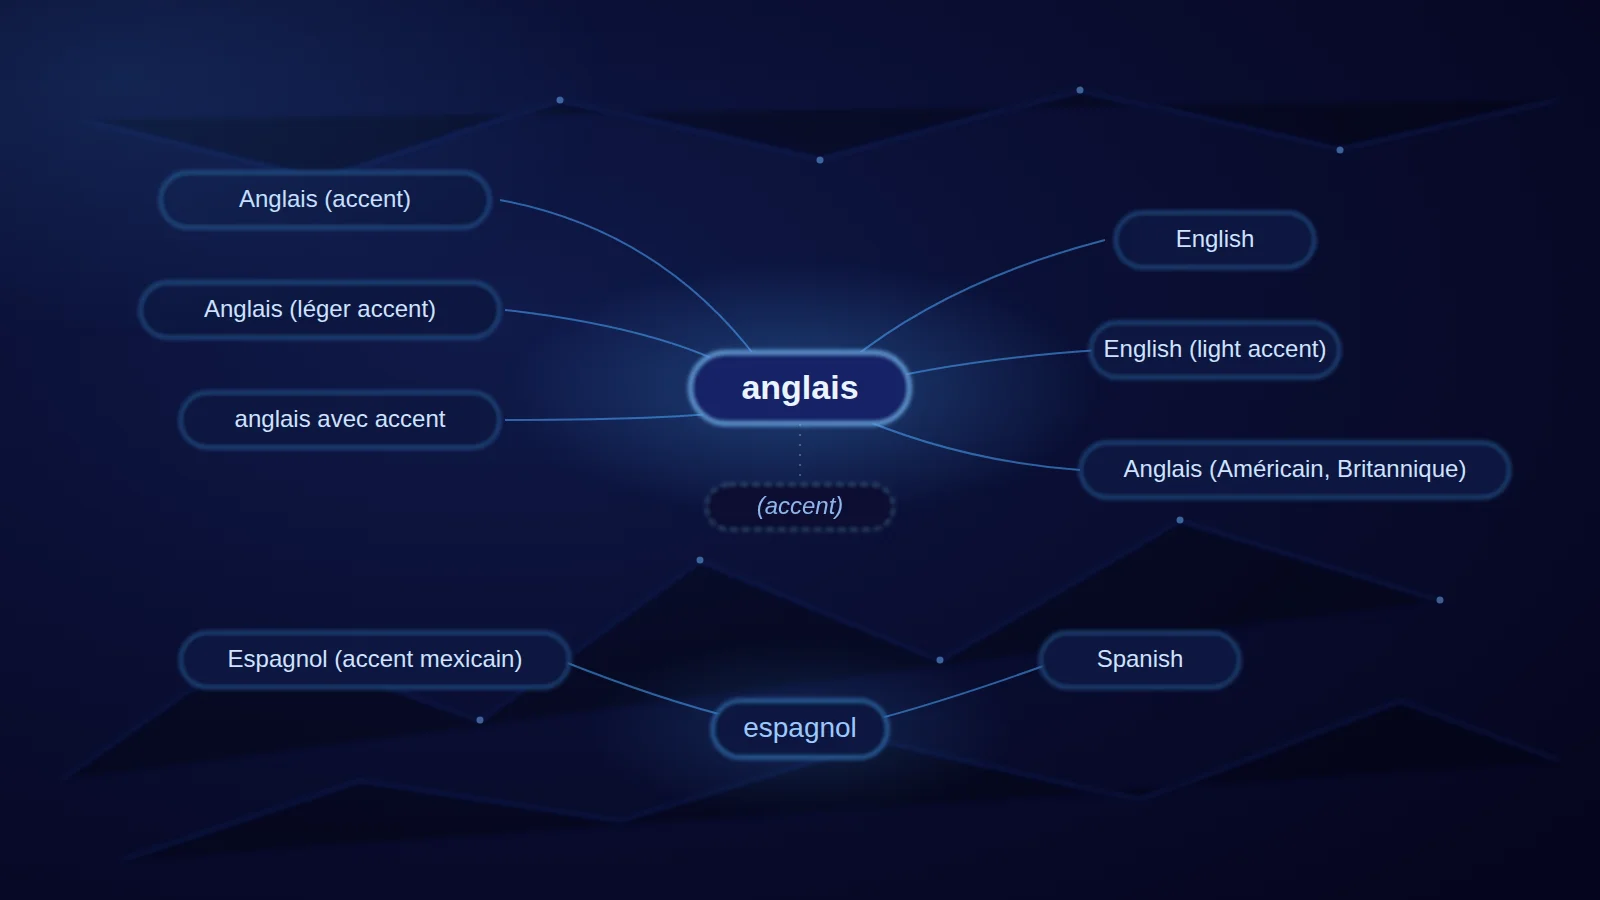
Ouvrez la colonne « langues » d'une vraie base de talents. On n'y trouve pas « Anglais » et « English » côte à côte et rien d'autre. On y trouve « Anglais (accent) », « Anglais (léger accent) », « anglais avec accent », « Anglais (Américain, Britannique) », « English (light accent) », « Coréen (notions) », « Créole haïtien », « LSQ ». Chaque profil est rédigé par une personne différente, dans la langue de son choix, avec la précision de son choix. Un comparateur exact ne reconnaît presque rien.
La réaction instinctive serait de traduire : faire passer tout le monde dans une langue commune avant de comparer. C'est la fausse bonne idée à deux étages. D'abord, la traduction détruit exactement l'information utile : « accent » et « notions » ne sont pas des détails, ce sont des indications de jeu. Ensuite, une traduction est une deuxième source de vérité : il faut la maintenir, la synchroniser, et elle peut mentir toute seule.
La décision : ne jamais traduire
La lecture automatique des appels de casting a été écrite sur le même choix : chaque critère reste dans la langue de l'appel source. La rencontre se fait donc autrement. Chaque écriture est rattachée à un canon, une forme standard, calculée en code déterministe. C'est le vieux réflexe des mathématiques : on ne compare pas 6/8 et 3/4 en regardant leurs chiffres, on les réduit d'abord à leur forme la plus simple. Un filtre sur « Anglais » et un profil qui dit « anglais avec accent » sont deux écritures du même canon, et le comparateur ne voit que le canon.
Trois règles, et une table d'alias
Le canon se calcule avec trois règles, dans l'ordre :
- Retirer ce qui est entre parenthèses. « Anglais (léger accent) » devient « Anglais ». La précision reste dans le profil, affichée telle quelle, mais elle ne participe plus au critère. La règle du produit est explicite : si la langue est sur le profil, c'est assez pour proposer le talent. L'accent est une nuance que l'agent pèse en écoutant la selftape, pas un critère de tri.
- Couper sur les séparateurs, jamais à l'intérieur des parenthèses. « Anglais (Américain, Britannique), Espagnol (accent d'Espagne) » donne deux valeurs, pas trois. Sans la parenthèse, une virgule aurait découpé un pays en une langue inventée.
- Retenir le mot reconnu le plus long. « Créole haïtien » garde ses deux mots, parce que « haïtien » le distingue du créole des Antilles françaises. Et ce que rien ne reconnaît reste inconnu : « ouvert à toutes les langues » ne devient pas anglais, parce que ce n'en est pas.
Le tout s'appuie sur une table d'alias, tenue à la main, pour les orthographes que les données réelles utilisent et qu'aucun menu n'affiche : Farsi et Persan pointent le même canon, LSQ est la langue des signes québécoise, Grecque rejoint grec. La table est petite, honnête, et grandit à chaque nouvelle orthographe croisée dans une vraie base.
| Valeur dans la base | Ce que le matching retient |
|---|---|
| « Anglais (léger accent) » | anglais, l'accent mis de côté |
| « Anglais (Américain, Britannique), Espagnol (accent d'Espagne) » | deux valeurs : anglais, espagnol |
| « Créole haïtien » | créole haïtien, pas seulement créole |
| « LSQ » | langue des signes québécoise |
| « ouvert à toutes les langues » | rien, on ne devine pas |
Une seule fonction lit les langues d'un profil
La seconde moitié du problème n'est pas le canon, c'est le nombre de lecteurs. Une base de talents est lue par le tri, par les filtres avancés, par le score, par les compteurs de langues de voix. Si chaque surface recoupe la colonne à sa façon, les mêmes données finissent par donner des réponses différentes selon l'écran. La règle du code est simple : une seule fonction lit les langues d'un profil, et toutes les surfaces passent par elle. Un filtre en français trouve le profil rédigé en anglais parce que les deux parlent au même canon, pas parce qu'on a traduit.
Traduire une base de talents, c'est ajouter une deuxième source de vérité. Réduire chaque écriture à son canon, c'est n'en ajouter aucune.
Ce que le patron enseigne
Le même patron règle les autres critères démographiques : le genre et l'origine ont chacun leur canon et sa table de synonymes, pour que « femme », « Female » et « féminin » pèsent le même poids. Et la leçon générale tient en une phrase : quand deux vocabulaires doivent se rencontrer, la question n'est pas « qui traduit qui », mais « quelle est la forme minimale où ils deviennent identiques ». C'est de la théorie des ensembles appliquée à un carnet d'adresses bilingue, et ça tourne en quelques microsecondes.


